这是与张翔宇的访谈,他是一位长期从事研究的科学家。 这并非传统意义上的同行评议科学论文,在我看来,这更像是一场更加详尽的、Ilya1级别的演讲。 我强烈建议你在一个非常理性的模式/环境中聆听/阅读它,值得你花时间。
Podwise2 已经自动生成了许多亮点和摘要 所以我不会在这里复制粘贴。 不过我会列出从这次演讲中得出的最重要的经验,以及与之相关的我的模糊思考
1. 仅依靠图像扩展性较差
这实际上是比原始演讲更大的断言,原演讲更多的是关于”图像自监督学习扩展性较差”。 首先,根本不存在所谓的无监督学习。 LLM有两种形式的强监督:1. 语言本身结构良好,2. 选择训练哪些数据本身就是一种标注形式。3 张翔宇的洞察是,视觉中的SSL实际上是有监督的,因此受到开发者制作增强技术知识的限制。更具体地说:
- 对比学习本质上是学习人类对颜色/尺度/长宽比等对象不变性的理解。
- 掩码自编码器本质上是学习遮挡不变性
但我们还希望有更多: 物理学、组合、对象关系、因果效应 视频中的SSL可能有机会解决这个问题,但时间冗余让我怀疑暴力扩展是否高效。VideoMAE 用很高的掩码比例利用这种冗余4;这并不能证明视频学习存在普遍的上限。更高效的解决方案还有待出现。
现在谈谈我个人对”监督学习同样扩展性较差”这一说法的看法。 虽然Google DeepMind5、Meta6 和 BAAI7也在视觉编码器的大规模扩展中显示出一些改进,但在我看来,这些改进某种程度上是锦上添花。 我怀疑它能否将许多应用从不好|好|优秀的使用层级中提升。 我甚至相信图像分辨率(因此利用的token数量)在图像理解中起着更大的作用,至少它确实在整体理解vs定位/OCR权衡中产生了显著差异8
2. LLM逆向扩展现象
这是来自9和10关于”涌现能力”11讨论的并发洞察 ,翔宇的洞察更容易理解:当 LLM 的模型规模变大时,它确实对解决(推理)任务有更好的直觉,因此它更倾向于走捷径直接说出答案,这比忠实地逐步解决问题产生更高的错误率。当得到适当指示(COT)时,更大的模型确实更好。
这让我想知道视觉是否可以完全通过数据+计算来解决?毕竟,原生视觉模型在你可以通过COT用更多计算进行推理时,并没有动态的”推理电路”。注意:我记得有一个通过自回归图像预测进行推理的例子,但尚未找回对应来源。因此这里保留为一个问题,不把它作为这项判断的证据。
3. 推理模型的力量
这是演讲中最迷人的部分。这已经不是秘密了
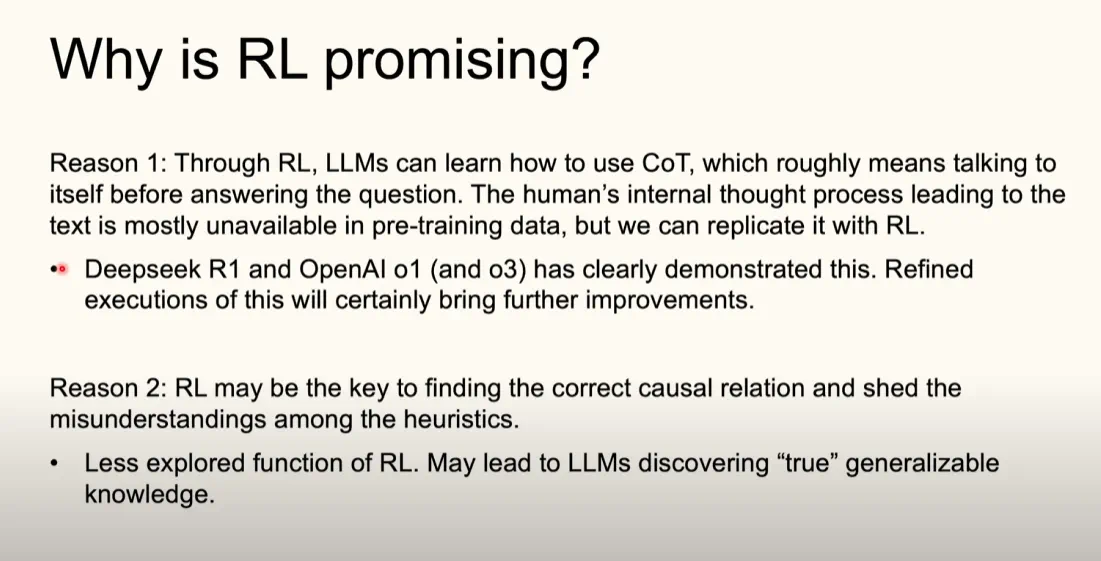
我对翔宇假设的理解是:许多推理模式已存在于预训练中,后训练帮助引出这些模式。我不把它理解为后训练绝不可能引入新知识的证明。RL只是更好地从预训练中引出现有模式(如CoT),顿悟时刻的词语(等等…)是高质量数学讨论数据中的常见短语。当与测试时计算结合时,允许模型在”思考路径”上动态利用更多token,具有更高的成功率,并且还能适应之前错误选择的路径。
我的直觉是:
- 与其在具有多模态性质和不可约方差的token上猛击,我们更希望监督思考电路
- RL是比SFT更好的搜索然后引出现有模式的方法
- 用外行的话来说,RL在 模型的观点 中探索更好的解决方案,并帮助模型在解决方案空间而不是token空间中发展 更好的”直觉”
更新:后来我找到一段解释 RL 为何有效的课程14,很有启发。
4. 图像推理的路径
OpenAI O3是15图像推理可能性的活生生的证明。 如果你还没有看过,一定要看看;真正特别,甚至神奇。
需要明确的是,O3图像实现在很大程度上仍然是未知的
翔宇的洞察是,这很可能也可以追溯到预训练
- 有很多关于图像的解释模式
- 其中几乎都是标注或简单地缩放到感兴趣的区域,例如修理电子产品、标记工具的特殊用法等。
- O3的思考模式可以看作是裁剪/缩放/标注模式的成功引出
- 顺便说一句,图像操作是通过 Python实时编码 实现的;虽然我认为更结构化/参数化的函数调用更合适
出处与延伸
参考资料
- Why Next-Token Prediction Could Surpass Human Intelligence: https://www.youtube.com/watch?v=Yf1o0TQzry8 ↩
- https://podwise.ai/dashboard/episodes/4209997 ↩
- 未核实的回忆:尚未确认原始演讲及讲者,因此这里不作为已确认的引述。 ↩
- VideoMAE: Masked Autoencoders are Data-Efficient Learners for Self-Supervised Video Pre-Training: https://arxiv.org/abs/2203.12602 ↩
- SigLIP 2: Multilingual Vision-Language Encoders with Improved Semantic Understanding, Localization, and Dense Features: https://arxiv.org/abs/2502.14786 ↩
- Perception Encoder: The best visual embeddings are not at the output of the network: https://arxiv.org/abs/2504.13181 ↩
- EVA-CLIP-18B: Scaling CLIP to 18 Billion Parameters: https://arxiv.org/abs/2402.04252 ↩
- 有关分辨率与表征取舍的相关证据:Perception Encoder, https://arxiv.org/abs/2504.13181。该研究并未证明分辨率普遍比模型规模更重要。 ↩
- Inverse Scaling: When Bigger Isn’t Better: https://arxiv.org/abs/2306.09479 ↩
- 逆向扩展可能变成U型:https://arxiv.org/pdf/2211.02011 ↩
- https://www.jasonwei.net/blog/common-arguments-regarding-emergent-abilities ↩
- SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training: https://arxiv.org/abs/2501.17161。结论针对实验中的规则与视觉变体,不是关于 SFT 的普遍定律。 ↩
- DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning: https://arxiv.org/abs/2501.12948 ↩
- [UCLA RL-LLM] Chapter 0: Course outline and prologue: https://www.youtube.com/watch?v=q9972BRoXzQ ↩
- https://simonwillison.net/2025/Apr/26/o3-photo-locations/ ↩